
AI&Data
Oct 15, 2026, 9:01:19 AM
AI Ready化とは?必要な条件や阻む要因、進め方を解説
企業や事業部門は、AIやBI(ビジネスインテリジェンス)ツールを活用することで、意思決定のスピードや精度を上げ、競争力を高めることが期待できます。そのためには、意思決定に使うデータを、正確で全社共通の意味で使える状態にそろえておく必要があります。
しかし、データが部門ごとに散在し、「顧客」や「売上」の定義もそろわず、分析に入る前の段階でつまずいている情報システム部門やDX推進室の担当者も多いのではないでしょうか。
こうした課題を解消し、データをさらに活用できる状態へ高めていく取り組みが、データマネジメントです。
この記事では、データマネジメントの役割や11の知識領域、進め方の5ステップ、よくある失敗、企業事例まで解説します。自社の現状と照らし合わせながら、着手すべき領域を整理できます。
\ データ・AI活用を一気通貫でサポート /
【この記事で分かること】
・データマネジメントの役割と、データガバナンスとの違い
・全社で取り組むべき11の知識領域と、進め方の5ステップ
・よくある4つの失敗と、東京ガス・NTTデータ・NECの実践例
データマネジメントとは、データを企業の「資産」として活用可能な状態に維持する組織的な活動です。データマネジメントを怠ると、データの確認や整理に時間がかかり、分析や意思決定、施策実行のスピードが低下します。全社のデータ活用を支える情報システム部門にとって不可欠であり、対応が遅れれば競争力の低下にもつながります。
データマネジメントの役割は、社内のデータを「安心して使える状態」に整え、その状態を維持することです。
たとえば、営業部は契約を獲得した時点の「受注金額」を、経理部は納品・検収を終えて計上した「売上」を、それぞれ自部門の実績として扱っているとしましょう。どちらも「今月の業績」として報告されれば、同じ月でも金額は一致せず、解釈のずれを招きかねません。そこでデータの定義や品質基準、アクセス権限、保管方法などを整理し、部門を越えて共通利用できる状態を構築します。
目的は管理そのものではなく、分析や意思決定、業務改善、AI活用などでデータの価値を引き出す土台を整備することです。
データガバナンスとデータマネジメントは対立する概念ではなく、ルールを決める側と、そのルールに沿って実行する側という関係にあります。
なお、データ管理の専門家団体であるDAMA Internationalがまとめた知識体系「DAMA-DMBOK」では、データガバナンスはデータマネジメントを構成する11の知識領域の1つであり、その中核に位置づけられています。広い意味ではデータガバナンスもデータマネジメントに含まれ、以下の表はその中での役割の違いを整理したものです。
|
項目 |
データガバナンス |
データマネジメント |
|
役割 |
方針・ルール・責任体制を定める |
定めたルールに沿って実行する |
|
具体例 |
顧客データの責任者や品質基準、アクセス権限を決める |
データを整備・統合し、品質を維持する |
|
主な担い手 |
経営層や推進組織が担う |
業務部門やIT部門が担う |
ガバナンスが不在のままマネジメントだけを進めても、部門ごとに基準が分かれ、全社での統合が難しくなります。
企業でデータマネジメントの重要性が高まっている背景には、大きく3つの変化があります。
以下では、それぞれの変化が現場にどのような課題をもたらすのか見ていきましょう。
企業では、CRMやSFA、会計システム、マーケティングツール、Excelなど、業務ごとに異なる場所へデータが蓄積されます。システムが増えるほど、同じ顧客や商品に関するデータでも名称・形式・更新タイミングが異なる状態が生まれます。
こうしたデータのサイロ化が進むと、分析のたびに各部門からデータを集め、意味を確認し、形式を揃えなければなりません。その結果、分析そのものより準備に時間を取られます。
全社でデータを活用するには、保存場所だけでなく、定義や品質、利用ルールまで横断的に整理する取り組みが求められます。
DXやデータドリブン経営では、経験や勘だけに頼らず、データを根拠として業務や経営の意思決定を進めます。
しかし、部門によって数字の定義が異なったり、最新データか判断できなかったりすれば、ダッシュボードを構築しても意思決定には使えません。分析基盤を整えるだけでなく、その中で扱うデータの意味・品質・責任を明確にする作業が前提となります。
生成AIやAIエージェントを業務へ組み込む際も、データマネジメントが重要です。AIが参照するデータの内容や意味が不明確であれば、適切な判断や回答にはつながりません。
そのため、データ品質だけでなく、「この項目は何を意味するのか」「誰が利用できるのか」といったメタデータや権限、業務上のコンテキストまで整理が求められます。
>データ基盤とは?構築のメリットやステップを解説
>AIエージェントとは?仕組みや生成AIとの違い、活用事例を解説
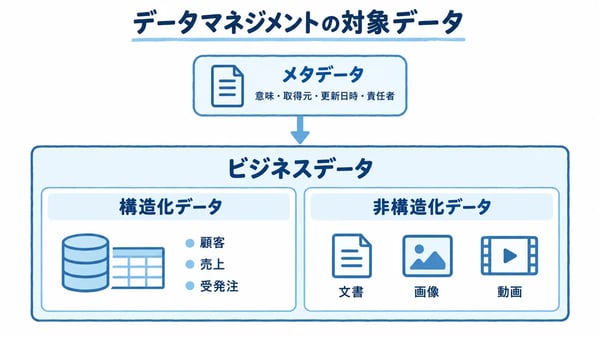
データマネジメントでは、データベースに格納された数値や文字列だけを対象にするわけではありません。企業活動で発生するビジネスデータには構造化データと非構造化データがあり、それらを正しく理解するためのメタデータも重要な管理対象です。
特に全社で活用する場面では、「データがある」という事実だけでは不十分です。どのシステムから来たのか、何を意味するのか、誰が管理しているのかまで把握して初めて、安全かつ継続的な利用が可能になります。
生成AIなどで非構造化データを利用する機会が増えるほど、ビジネスデータとメタデータを一体で管理する視点が求められます。
データマネジメントを体系的に捉える際に参考になるのが、DAMA Internationalの知識体系「DAMA-DMBOK」です。
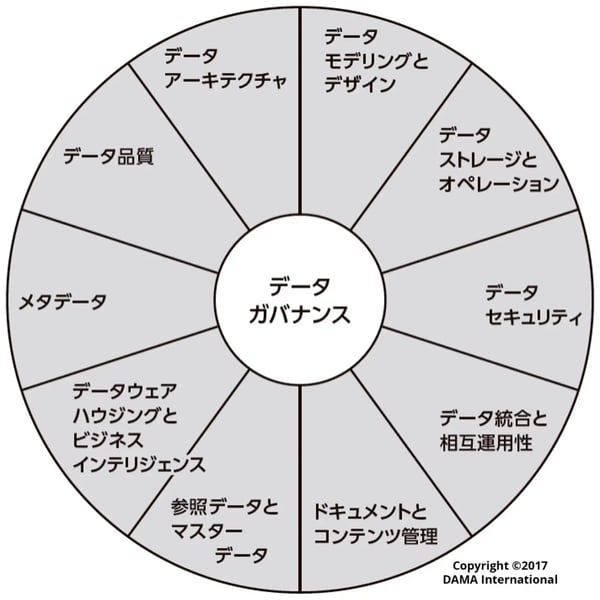
出所:『データマネジメント知識体系ガイド 第二版』 DAMA International編著、DAMA日本支部、Metafindコンサルティング株式会社 監訳、日経BP
DAMA-DMBOKは、中心に置かれたデータガバナンスと、その周囲に配置された他の10領域、合わせて11の知識領域を「DAMAホイール」として示しています。データ品質やメタデータ管理といった個別領域の知識を深めるだけでなく、データガバナンスを中心に、各領域の一貫性と相互のバランスを保ちながら、11の領域全体に取り組む必要があるという考え方です。
|
知識領域 |
主な役割 |
|
データガバナンス |
データ管理の方針・役割・基準を定め、組織全体を統制する |
|
データアーキテクチャ |
全社のデータ構造やデータの流れを設計・管理する |
|
データモデリングとデザイン |
データ同士の関係や構造をモデルとして設計する |
|
データストレージとオペレーション |
データを適切に保存・取得し、安定して運用する |
|
データセキュリティ |
不正アクセスや漏えいなどからデータを保護する |
|
データ統合と相互運用性 |
異なるシステムやデータソース間でデータを連携・統合する |
|
ドキュメントとコンテンツ管理 |
文書や画像などの非構造化データを適切に管理する |
|
参照データとマスターデータ |
コード体系や顧客・商品など、組織で共有するデータの整合性を保つ |
|
データウェアハウスとビジネスインテリジェンス |
分析・レポート・意思決定に利用できるデータ環境を整える |
|
メタデータ管理 |
データの意味・定義・所在・来歴などの情報を管理する |
|
データ品質 |
データの正確性・完全性・一貫性などを維持・改善する |
参考:DAMA International「The heart of DAMA-DMBOK®」をもとに作成
データマネジメントの実践は、システム保守の枠を超えて組織全体の価値を高める推進力になります。正確で鮮度の高いデータがすぐ手に入る環境が整えば、意思決定の迅速化や業務コストの削減、セキュリティリスクの低減といった効果が広い範囲に及びます。
ここでは代表的な4つを見ていきましょう。
データマネジメントでは、項目の定義や入力ルール、品質基準を揃え、重複・欠損・不整合などを継続的に確認します。
これにより、「この数字は正しいのか」「営業部と経理部で集計結果が違うのはなぜか」といった確認作業を減らせます。
ポイントは、一度データを整備しただけで終わらせないことです。データは日々追加・更新されるため、品質チェックの責任者や修正フローまで含めて運用すると、分析やAIに利用できる信頼性を維持しやすくなります。
社内でデータの定義や所在が整理されると、必要な情報を探したり、部門ごとの数字を照合したりする時間を削減できます。
経営会議の資料を作るたびに複数部門からExcelを集める進め方では、集計に入る前に形式や定義を揃える工程が必要です。共通の定義で整理されたデータをすぐ確認できる状態と比べると、意思決定までの速度には大きな差が生まれます。
さらに、同じ基準で整理されたデータを全社で利用すれば、部署によって異なる数字を前提に議論する問題も抑えられ、判断の一貫性が高まります。
データが分散している企業では、同じデータを複数部門で入力したり、分析のたびに収集・加工したりする作業が避けられません。
データの取得元や加工方法を標準化し、必要なデータを再利用できる状態にすれば、こうした重複作業を減らせます。
また、似た用途のデータやシステムが社内に重複している状況も把握しやすくなります。データマネジメントは、分析担当者だけでなく、日常的な入力・集計・確認業務を行う各部門の生産性向上にもつながる取り組みです。
データ活用を広げるほど、「誰でも何でも見られる状態」を放置できなくなります。
データマネジメントでは、データの重要度や用途に応じて、管理責任者やアクセス権限、利用ルールを整理します。必要な人にはデータを提供しながら、不要なアクセスは制限するという使い分けです。
さらに、データの所在や責任者を把握しておけば、問題が起きた際にも影響範囲を確認しやすくなります。活用と統制を別々に考えず、両方を維持できる状態の構築が重要です。
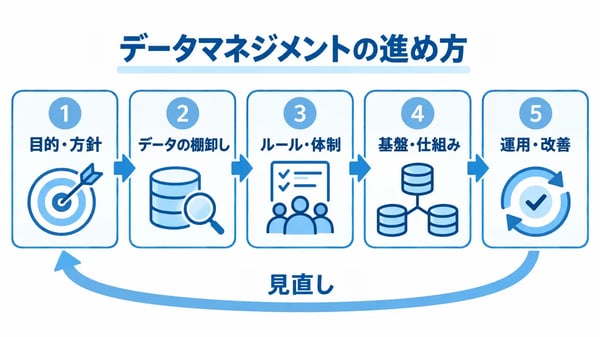
導入を成功させるには、全社一括の大型投資よりもスモールスタートが有効です。目的を定めて特定の部門から小さく始め、順を追ってルール整備と基盤運用を広げていく進め方が向いています。
ここでは定着までに踏む5つのステップを順に見ていきます。
最初に決めるべきなのは、導入するツールではなく「何のためにデータを整えるのか」です。
たとえば「経営会議で売上と利益を迅速に確認したい」「営業とマーケティングで顧客データを共有したい」など、具体的な業務課題から対象範囲を決めます。
どこから始めるか迷う場合の優先候補は、経営への影響が大きく、現場でもデータの不整合による負担が顕在化している領域です。目的と成果指標を先に定めれば、必要なデータやルールも絞り込みやすくなります。
次に、目的達成に必要なデータについて「何が、どこに、どの状態であるか」を整理します。
確認する対象は、データの保管場所だけではありません。項目の意味、更新頻度、利用部門、管理担当者、重複や欠損の有無なども棚卸しの対象です。
この作業を進めると、「顧客IDがシステムごとに違う」「同じ売上でも部門によって定義が違う」といった課題が見えてきます。全データを一度に調べるのではなく、最初に定めた目的に必要な範囲から着手すると進めやすくなります。
データ品質を長く保つには、ルールの明文化と組織体制の整備が必要です。
プロジェクトを統括する推進組織のもとに、データの権利と責任を持つ「データオーナー」、現場で品質を管理する「データスチュワード」といった役割を定義します。それぞれの責任範囲と業務ガイドラインを決めておくと、ルールが形だけの決まりごとになる事態を避けられます。
目的、対象データ、ルール、役割が決まったら、それらを実行できる仕組みを整えます。
必要に応じて、データ連携、DWH(データウェアハウス)・データレイク、データカタログ、マスターデータ管理、品質チェック、アクセス制御などを構築します。
ここでも製品選定から始めるのではなく、必要なデータの量や種類、利用方法、既存システムとの連携などから設計する順序が重要です。
>データ分析基盤のアーキテクチャとは?AI活用を見据えた設計のポイントも解説
データマネジメントは、基盤やルールを作れば完了するプロジェクトではありません。業務やシステムが変われば、データの種類や定義、利用方法も変化します。
そのため、品質指標や利用状況を継続的に確認し、問題があればルールや仕組みを見直します。
また、現場から「必要なデータが見つからない」「ルールが複雑で運用しにくい」といった声を集める取り組みも有効です。運用実態に合わせて改善を続けることで、管理のための活動ではなく、実際に利用されるデータマネジメントとして定着していきます。
データマネジメントは、途中で頓挫するケースも少なくありません。その多くは、目的の曖昧さや、現場の不満・組織的な壁を見通せないまま進めたことが原因です。
典型的な失敗のパターンと防ぎ方を、あらかじめ押さえておきましょう。
高機能なデータ基盤や統合ツールを導入すること自体が目的になってしまうのは、よくある失敗の一つです。「最新のツールを入れれば課題は解決する」と考えると、結局は誰にも使われない基盤だけが残ります。
ツール選びに動き出す前に、「何を解決し、どんなビジネス成果を得たいのか」を明確にしておく必要があります。
各部署が自部門の都合だけで名称やコード体系を決めていくと、全社での統合は進みません。一部の部署だけで決めた基準をそのまま使い続けても、他部門のデータとかみ合わないためです。例えば、営業部の「受注金額」と経理部の「売上」を同じ業績の数字として扱おうとすれば、集計のたびに手作業の変換が発生します。
全社横断で旗振り役を担う部門や推進組織を定め、各事業部と合意形成を図りながら共通のデータ標準をつくっていく進め方が求められます。
ガイドラインを作っても、維持する責任者が曖昧なままでは規則はすぐに形だけの決まりごとになります。「誰かが対応するだろう」という状態が続くと、入力の不備や形式の乱れが放置されてしまうためです。
データ領域ごとの管理責任者(データオーナー)と現場の実務担当者(データスチュワード)を具体的に指名し、人事評価の基準にも組み込んでおくと運用が安定します。
データの入力や管理が「余計な手間が増えただけ」と受け取られると、ルールは守られなくなります。入力負荷を軽くするUI/UXの工夫や、データ整備で業務がどう楽になるのかというメリットの提示が防止策になります。
運用開始のタイミングでは研修やサポート体制を用意し、現場を孤立させない配慮が欠かせません。
データマネジメントの進め方は企業によって異なりますが、先行事例には共通点があります。
単にデータ基盤を構築するのではなく、データ品質、メタデータ、標準化、組織体制、ガバナンスまで含めて整備している点です。ここでは、全社的なデータ活用へつなげている3社の事例を紹介します。
東京ガスでは、全社データ分析基盤の利用者が1万人規模へ拡大するなかで、中央集権型の運用による拡張性やガバナンス、データ定義の属人化が課題となっていました。
|
項目 |
内容 |
|
課題 |
利用者の拡大に伴い、中央集権型の管理では対応が難しく、データ定義も属人化 |
|
施策 |
各事業部門がデータ品質に責任を持つデータメッシュ(※1)型へ移行し、連邦型ガバナンス(※2)を整備 |
|
成果 |
自律分散型のデータ活用体制を構築し、AIがデータを利用しやすい「AI Ready」環境の整備にも発展 |
※1 データメッシュ:データを中央の専門部署で一元管理するのではなく、データを最もよく知る各事業部門が自部門のデータの品質や提供に責任を持つ分散型の考え方
※2 連邦型ガバナンス:全社共通のルールや標準は中央で定め、その運用を各部門に委ねるガバナンスの形
東京ガスiネットと連携し、データアーキテクチャ、メタデータ、データ保護、データ品質を軸にしたガバナンスを構築しています。この取り組みは、データマネジメントで他の模範となる企業・機関を表彰するJDMC(日本データマネジメント・コンソーシアム)の「データマネジメント賞2026」でデータマネジメント大賞を受賞しています。
参照:東京ガス「2026年「データマネジメント大賞」を受賞」
NTTデータでは、データ収集・加工プロセスの複雑化などを背景に、経営管理を支えるデータ活用基盤を再構築しました。
|
項目 |
内容 |
|
課題 |
データ収集・加工が複雑化し、安定したデータ活用と品質維持が必要 |
|
施策 |
Snowflake、Informatica、Tableauを活用し、データモデルや連携方式を標準化 |
|
成果 |
500本以上のチェック処理を毎日自動実行し、リリース後1年半で約5,000名へ利用が拡大 |
基盤を作るだけでなく、数値検証やデータチェックを日常運用へ組み込んでいる点が特徴です。さらに、基盤構築と活用推進を異なる組織が連携して担うことで、品質の維持と利用拡大を両立しています。
参照:NTTデータ「経営を動かすデータの力~NTTデータのデータ活用基盤構築・推進の全貌」
NECは、データドリブン経営を支える「One Dataプラットフォーム」を整備し、社内データを活用しやすい環境づくりを進めています。
|
項目 |
内容 |
|
課題 |
必要なデータがどこにあるのか分かりにくく、探索や確認に工数が発生 |
|
施策 |
ビジネスカタログとデータカタログを整備し、データ専門組織がガバナンスのCoE(Center of Excellence:専門知識やノウハウを集約し、全社の取り組みを支援・推進する組織)としての役割を担う |
|
成果 |
データ探索工数を大幅に削減し、生成AIを含むAI活用や意思決定の高度化にも展開 |
データの所在だけでなく、標準データの意味まで整理している点が重要です。加えて、データ戦略や品質管理ガイドライン、人材育成も推進し、仕組みと組織の両面からデータ活用を支えています。
参照:NEC「NECにおけるデータドリブン経営の取り組み」
データマネジメントは、データを保存するためのツール導入でも、一度きりのシステム構築プロジェクトでもありません。データを企業の資産として活用できるよう、体制・ルール・品質・基盤・運用を継続的に育てる経営活動です。
東京ガス・東京ガスiネット、NTTデータ、NECの事例からも、データ活用やAI活用を進める企業が、データ品質、標準化、メタデータ、ガバナンスといった領域を同時に整備していることが分かります。データ基盤や生成AIを導入しても、その中で扱うデータが信頼できなければ十分な価値を引き出せません。
社内のデータが散在しているなら、最初から全社を対象にする必要はありません。まず経営・業務上の目的を決め、必要なデータを棚卸しし、責任者とルールを明確にするところから始めましょう。
サークレイスは、データマネジメントの目的・方針づくりにあたる計画・構想策定から、Data PlatformやDatabricksを活用した基盤の実装、Salesforce Data Cloudによるデータ統合、定着に向けた運用・伴走支援までを提供しています。支援の軸は、技術の導入そのものではありません。目的設計から体制・仕組みまでを一続きに整え、AI・データ活用による業務変革や意思決定の高度化を目指す企業を後押しします。
\ データ・AI活用を一気通貫でサポート /


