
データクレンジングとは?メリットや手順、失敗を防ぐポイントを解説
2026.10.01 サークレイス株式会社
マーケティング・営業企画部門で、蓄積した顧客情報や営業データを分析やAI活用に生かしたい——そう考えたときに立ちはだかるのが、表記ゆれや重複、欠損といったデータの状態です。品質が整っていなければ、分析結果も顧客対応も、生成AIの出力精度も揺らぎます。
この記事では、データクレンジングの意味や目的から、具体的な方法、進め方、よくある失敗、活用できるツールまでを解説します。IT・情報システム部門やマーケティング・営業企画の担当者が、自社に必要な改善策を整理するための材料としてお使いください。
\ データ・AI活用を一気通貫でサポート /
【この記事で分かること】
・データクレンジングの目的と、データクリーニングや名寄せとの違い
・5つの主な方法と6ステップの進め方
・よくある失敗の対策とデータクレンジングに使えるツール・サービス
データクレンジングとは?
データクレンジングとは、データベースに蓄積された不正確なデータや表記ゆれ、重複、欠損値などを見つけ出し、修正や削除によって品質を高める作業を指します。AIを活用した分析や予測、生成AIによる出力精度はインプットデータの質に大きく依存するため、データ活用やAI導入の前提となる工程と言えます。
一度修正すれば終わりという作業ではなく、継続的に品質を維持する取り組みとして設計します。
データクレンジングの目的
データクレンジングを実施する主な目的は、組織全体で保有するデータの信頼性と活用価値を高める点にあります。
例えば、不整合なデータを放置したままでは、売上分析の結果が実態からずれたり、同じ顧客へ二重に連絡してしまったりといったトラブルを招きかねません。正確なデータ基盤が整えば、マーケティング施策のパーソナライズや精度の高い需要予測も現実的な選択肢になります。
手作業による修正コストを抑え、データの処理速度や検索性を向上させる効果も得られます。データを健全な状態に保つ作業は、ビジネス成果に直結する戦略的な意思決定を支える基盤づくりそのものです。
データクリーニングや名寄せとの違い
データクレンジングと混同されやすい言葉に、データクリーニングや名寄せがあります。それぞれの違いは、以下のとおりです。
データクレンジングとデータクリーニングは、一般的にほぼ同義として扱われます。一方、名寄せは同一人物や同一企業に関する複数の情報を判定し、一つにまとめる処理です。
データクレンジングが表記ゆれや誤記、欠損値など幅広い不備を対象とするのに対し、名寄せは同一対象の判定と統合に範囲を絞っている点が異なります。
データクレンジングが重要視されている背景
企業が扱うデータは量・種類ともに増え続けており、その品質が分析結果や日々の業務精度に直接影響します。ここでは、データクレンジングの重要性が高まっている背景を5つの観点から整理します。
- 企業が扱うデータ量が増加している
さまざまなシステム活用やデジタル化により顧客情報や取引履歴をはじめとするデータの取得・蓄積が進み、重複・欠損・表記ゆれなどが発生しやすくなっている。 - 複数のシステムやツールにデータが分散している
CRM(顧客関係管理)、SFA(営業支援システム)、MA(マーケティングオートメーション)などの導入により、異なる形式のデータを統合・連携する機会が増えている。 - データに基づく意思決定が重視されている
経営判断や営業、マーケティングなどでデータ分析を活用する機会が増え、元データの品質が問われるようになっている。 - 顧客データの高度な活用が進んでいる
顧客分析やパーソナライズ施策を行ううえで、重複や誤りのない正確な顧客情報が必要になっている。 - 生成AIやAIエージェントの活用が拡大している
生成AIやAIエージェントなどが社内データを参照する機会が増え、回答や処理の精度を高めるためにデータ品質の重要性が増している。
データクレンジングのメリット
データクレンジングの実施は、単なるデータの整理で完結するものではありません。分析精度の向上からAI活用の最適化、全社的な共有基盤の確立まで、企業経営や日常のオペレーションに幅広い効果をもたらします。
組織全体が得られる主なメリットを、6つの観点から順番に紹介します。
データ分析の属人化を防ぎ、全社で同じデータを使える状態になる
部門ごとに独自の手法でデータを管理・補正していると、部署間で数値の齟齬が生じ、全社的なデータ利活用が滞ります。
データクレンジングの手順と表記ルールを標準化すれば、どの部署からアクセスしても同じ定義でデータを扱える環境が整います。特定の担当者しかデータの状態を把握できていない、いわゆる属人化の解消にも有効です。
部門を超えたスムーズな連携と、一貫性のある分析が実現します。
業務効率化と手戻り削減につながる
不正確なデータが混在した現場では、リストの修正や事実確認の問い合わせといった本来不要な作業が日常的に発生します。事前にデータクレンジングを徹底しておけば、営業活動やマーケティング施策の実施時にデータを手作業で見直す手間を大幅に減らせます。
修正に伴う手戻りが減り、従業員が顧客交渉や企画立案といったコア業務へ向き合う時間を確保できる点も大きな変化です。無駄なデータ整理から解放されることで、組織全体の業務プロセスがスムーズに回り始めます。
無駄なコストを削減できる
データクレンジングは、直接的なコストと間接的なコストの双方の削減に寄与します。
例えば、重複した顧客データへダイレクトメールやメールマガジンを二重配信すると、発送費やツール利用料が無駄に膨らみます。重複を排除すれば、マーケティング費用や通信費の無駄遣いをそのまま削減することが可能です。
不要なデータを精査して絞り込む作業には、ストレージ容量の節約やデータベースの負荷軽減という副次的な効果もあります。維持管理コストを最小限に抑えるうえでも、データのスリム化は有効な手段です。
顧客対応の品質と信頼性が高まる
正確な顧客情報の保持は、カスタマーサポートや営業対応の品質を決める要素です。氏名の漢字の誤りや旧住所への案内送付、同じ顧客への複数担当者からの重複連絡は、企業の社会的信用を大きく損ないます。
データクレンジングによって最新かつ正確な顧客属性を維持できれば、一人ひとりに合わせた適切なコミュニケーションが可能です。顧客にストレスを与えない丁寧な対応の積み重ねが、満足度の向上と長期的な信頼関係の構築につながります。
分析精度と意思決定の質が上がる
整備された高品質なデータを使うことで、データ分析の精度は大きく向上します。重複や入力ミスが含まれたデータに基づく分析では、市場の本当のニーズや売上動向を見誤りかねません。
正確な分析結果は、経営陣や各部門の担当者に対して客観的で信頼性の高い根拠を提供します。意思決定の高度化が進めば、感覚や経験だけに頼った判断から脱却し、事業リスクを抑えた戦略的な施策を迅速に打ち出せます。
着実な事業成長を目指す局面において、確かなデータは有力な判断材料です。
AI活用の精度と信頼性が高まる
生成AIや機械学習モデルを業務へ組み込む場面では、入力データの質がそのまま出力結果の信頼性に反映されます。不完全なデータやノイズの多いデータを用いてAIを運用すると、偏った予測や不正確な回答を招く原因になりかねません。
データクレンジングによってノイズを取り除き、品質の高いデータを利用できる状況にすれば、生成AIの回答制度や機械学習モデルの予測精度の向上につながります。AIが示す提案や分析結果の信頼性が担保され、ビジネスにおけるAI活用の価値も最大化されます。
\ データ・AI活用を一気通貫でサポート /
データクレンジングの主な方法
データクレンジングで行う具体的な処理は、データの不備の種類に応じて多岐にわたります。主な手法として挙げられるのは、以下の5つです。
- 表記ゆれの統一
- 入力形式・データ型の統一
- 重複データの削除
- 欠損値の補完と削除
- 外れ値・異常値の処理
それぞれの具体的なアプローチを個別に見ていきます。
表記ゆれの統一
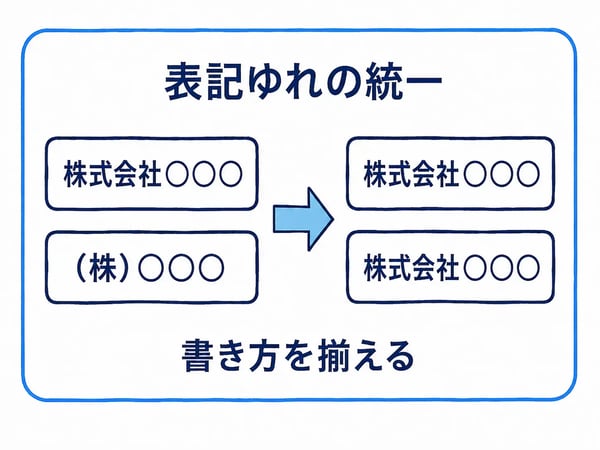
表記ゆれの統一は、同じ意味を持つデータの書き方を一つの形に揃える作業です。
「株式会社」と「(株)」、全角と半角、大文字と小文字といった違いは、システム上では別の値として認識されます。住所の「1-2-3」と「一丁目二番三号」も同じ問題を引き起こします。
効率よく進めるなら、あらかじめ正式表記のルールを決め、置換や関数で一括変換する方法が有効です。ここを揃えておけば、後続の重複チェックの精度も上がります。
入力形式・データ型の統一
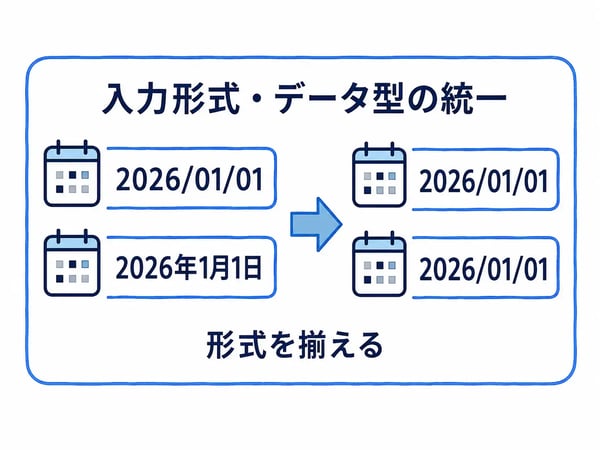
入力形式やデータ型を揃える作業は、システム間でデータを連携する際に重要になります。
日付が「2026/01/01」と「2026年1月1日」で混在していれば、期間で絞り込む集計は正しく動きません。電話番号のハイフンの有無や、数値が文字列として保存されている状態も同様です。
入力規則を設定し、そもそも異なる形式が混ざらない仕組みにしておくと、後の修正作業を減らせます。
重複データの削除
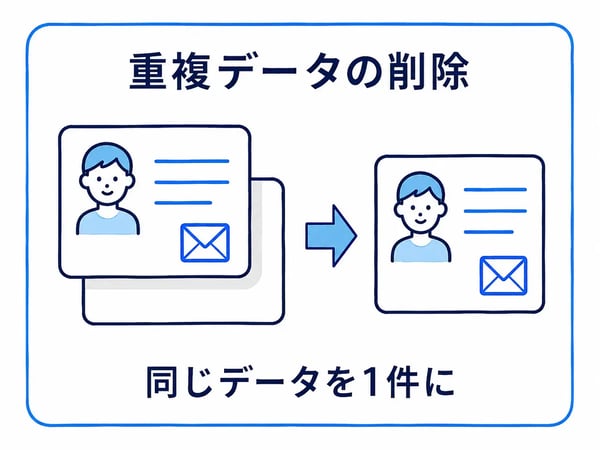
重複データの削除は、同一の顧客や企業の情報が複数登録されている状態を解消する作業です。完全に一致する情報は機械的に判定できますが、表記が微妙に異なる重複は見つけにくくなります。
メールアドレスや電話番号など、一意性の高い項目を基準に突き合わせると、検出漏れを防げます。どの情報を残し、どの情報を統合するかを事前に決めておけば、作業中の判断で迷いません。
欠損値の補完と削除
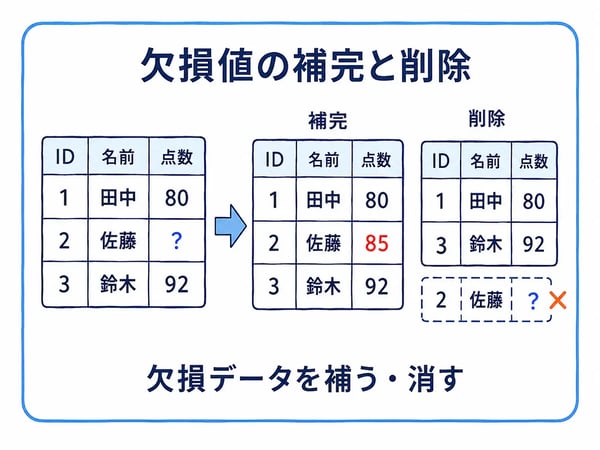
欠損値への対応は、補完するか削除するかを項目の重要度に応じて判断します。業種や従業員規模のように分析軸として使う項目が空欄なら、外部データや既存情報から補完する価値があります。
一方、分析にほとんど影響しない項目の欠損まで埋めようとすると、労力に見合う成果は得られません。欠損が多すぎる情報については、分析対象から外す判断も選択肢に入ります。
どの基準で補完し、どこから除外するかを決めてから着手すると、作業がぶれません。
外れ値・異常値の処理
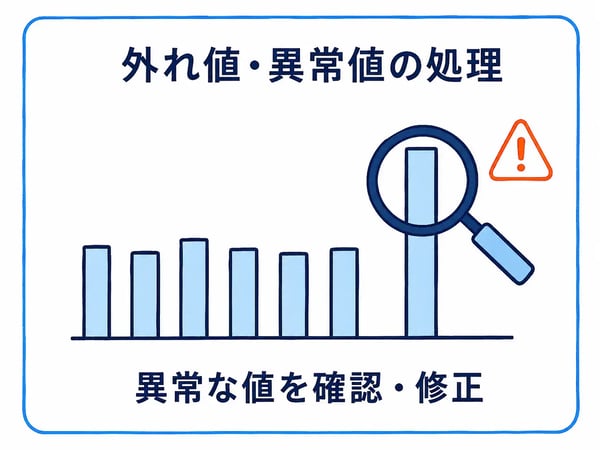
他のデータと比べて極端に離れた数値や、論理的にあり得ない数値を抽出して対応する作業です。
年齢欄に「150」と入力されているような誤入力や、単位の打ち間違いによる異常値が代表例として挙げられます。
放置したまま集計すると統計分析の結果が大きく変わるため、あらかじめ定義した閾値を超えたデータを抽出し、個別確認や修正、集計対象からの除外を行います。
データクレンジングの進め方6ステップ
データクレンジングを円滑かつ確実に成功させるには、体系的なステップを踏んで進めることが重要です。場当たり的な修正作業を避け、全体像を把握したうえで取り組む必要があります。
ここでは、安全かつ効果的に進めるための基本的な6つの手順を順番に解説します。
- 対象範囲と活用目的を決める
- 社内のデータを1か所に集約する
- データの品質をチェックする
- ルールを定めてクレンジングを実施する
- データを整理して活用しやすく格納する
- 入力プロセスを見直し定期実施する
Step1 対象範囲と活用目的を決める
最初に、どのデータベースのデータを何の目的でクレンジングするのかを明確にします。データクレンジング自体が目的化すると、不要な処理や過剰な修正が発生し、限られたリソースの浪費につながりやすい点に注意が必要です。
「SFAの営業分析精度を高める」「MAツールの配信エラーをゼロにする」といった最終ゴールを設定すれば、修正すべき優先項目や許容できる精度レベルが自然と定まります。
Step2 社内のデータを1か所に集約する
各部署のローカル環境や複数のシステムに点在している対象データを、データウェアハウス(DWH)や作業用サーバーといった1か所へ集約します。データが分散したまま個別にクレンジングを進めると、不整合や作業漏れを招きます。
元データを参照・集約し、全社を俯瞰できる共通の作業環境を用意する工程が、正確なデータの処理・統合を実現する前提条件です。
Step3 データの品質をチェックする
集約したデータに対してデータアセスメントを実施し、品質の問題点を可視化します。欠損値の割合、重複データの発生率、表記ゆれのパターン、入力形式のばらつきなどを詳細に洗い出す工程です。
データの乱れ具合やエラーの傾向を定量的に把握できれば、次に策定する標準化ルールの内容や、修正に要する工数・コストを正確に見積もれます。
Step4 ルールを定めてクレンジングを実施する
品質評価の結果に基づき、具体的な変換・修正ルールを定義したうえでクレンジング処理を実行します。「全角英数字を半角に統一する」「会社名辞書を参照して正式名称に置換する」といったロジックを、着手前に確定させておく形が理想的です。
自動処理ツールやスクリプトで一括変換を行いつつ、自動判定が難しい例外データには手作業での確認や個別補正を組み合わせて慎重に対応します。
Step5 データを整理して活用しやすく格納する
処理が完了したデータを、利用するシステムや分析基盤に適合する形で格納します。アクセス権限の設定やインデックスの付与を行い、各部門のユーザーが迅速にデータを検索・参照できる状態へ整える作業です。
データ構造をドキュメント化しておけば、活用時の混乱を防ぎ、クレンジング済みデータの価値を最大限に引き出せます。
Step6 入力プロセスを見直し定期実施する
クレンジングを一度きりの作業で終わらせず、きれいな状態を維持し続ける仕組みを構築します。データ入力フォームに制限を設けるなど、データの発生源で表記ゆれや誤入力を仕組みとして防ぐ工夫が効果的です。
定期的なクレンジング処理のスケジュール化や監視体制も組み込み、時間の経過に伴う品質の劣化を未然に防ぐ運用を定着させます。
\ データ・AI活用を一気通貫でサポート /
データクレンジングでよくある失敗と対策
データクレンジングは、進め方を誤ると時間をかけても成果が出ません。多くの失敗の原因は、着手前の準備と最終確認の不足です。ここでは現場で起こりやすい4つの失敗と、その対策を整理します。
- ルールが曖昧なまま着手してやり直しになる
- バックアップを取らず原本を上書きしてしまう
- 削除・丸めすぎで必要な情報を失う
- ツール任せで最終確認を省いてしまう
ルールが曖昧なまま着手してやり直しになる
変換ルールや表記の統一基準を曖昧にしたまま作業を始めると、作業者ごとに判断基準がぶれ、修正結果に新たな不整合が生まれます。途中で仕様変更が発生し、全データの再処理を余儀なくされるケースも珍しくありません。
こうした手戻りを防ぐには、住所の番地表記や法人格の略称ルールをガイドラインとして文書化しておく方法が有効です。関係者間で認識を揃えてから処理を実行すれば、大規模な手戻りのリスクを大きく減らせます。
バックアップを取らず原本を上書きしてしまう
クレンジング処理を実行する際、元のデータベースへ直接上書き更新をかける方法は極めて危険です。自動置換のロジックに誤りがあった場合、必要なデータが不可逆的に消去・改変され、復元できない事態に陥ります。
処理を開始する前に、未加工の原本データを必ずバックアップとして取得・保存しておきます。テスト環境や退避用テーブルで変換処理を試し、検証を経てから本番へ反映する手順が安全策です。
削除・丸め過ぎで必要な情報を失う
クレンジングを過度に進めた結果、ビジネス分析において価値のある情報までそぎ落としてしまうこともあります。欠損値のある情報を機械的に一括削除したことでサンプル数が極端に減り、統計解析の信頼性が損なわれるケースが典型例です。
数値を丸めすぎた結果、微細な購買傾向を検出できなくなる問題も起こります。データを削除・加工する場面では、分析目的への影響を慎重に吟味し、代替手段の検討も含めて判断します。
ツール任せで最終確認を省いてしまう
クレンジングツールやAIの自動変換機能を全面的に信頼し、目視での最終確認を怠ると、誤った変換に気付けません。同姓同名の別人を同一人物と誤判定して統合してしまうケースや、珍しい社名が誤った標準名称へ置換されるケースがあります。
高度なツールを活用する場合でも、処理結果のサンプリング調査や人の目によるダブルチェック工程を組み込んだ設計が求められます。自動化と人的確認のバランスをどう設計するかによって、維持できる品質の水準が変わります。
データクレンジングに使えるツール・サービス
データクレンジングの実現手段は、扱うデータの規模や自社の目的によって変わります。単一のツールに絞り込むのではなく、自社のデータ基盤の状況や課題感に照らして最適な組み合わせを選ぶ視点が大切です。
ここでは代表的な3つのツール・サービスを紹介します。
表計算・SQLなど汎用ツール
ExcelやGoogleスプレッドシートの関数機能、あるいはRDBMS(リレーショナルデータベース管理システム)のSQLクエリを活用してクレンジングを行う方法です。追加のツール導入コストを抑えられ、小規模なデータや単発の修正作業であれば手軽に対応できます。
一方で、データ量が数万〜数十万件規模になると動作が著しく重くなり、複雑な名寄せロジックの構築には高度なスキルが必要になります。属人化しやすく自動化にも限界があるため、大規模なデータ運用や継続的な品質管理には向かない手法です。
データクレンジング/名寄せ特化ツール
住所辞書や企業データベースを標準搭載し、表記ゆれの補正や名寄せ処理に特化した専用ソフトウェアです。高度な照合アルゴリズムを備えており、住所の表記ゆれや法人名の変遷を自動で照合し、高い精度で統合できます。
手作業や表計算ソフトでは扱いきれない大量の顧客データを高速に処理できるため、CRMやSFAのデータ精度を短期間で引き上げたい企業に適した選択肢です。他システムとのリアルタイム連携については、別途設計が求められる場合もある点に注意が必要です。
ETL・データ統合/データ基盤プラットフォーム型
SnowflakeやDatabricks、Salesforce Data Cloud、データの抽出・変換・書き出しを担うETLサービスなどが代表例です。複数システムに散在するデータの集約を自動化し、一元化されたデータ基盤上でクレンジングを常時実行できます。
導入にあたっては、単なる製品選定ではなく、継続的な品質担保と全社でのデータ活用を見据えた経営判断が必要になります。データガバナンスの強化や将来的なAI活用まで視野に入れた、持続可能なデータ基盤を構築する場面で真価を発揮します。
\ データ・AI活用を一気通貫でサポート /
まとめ
データクレンジングとは、蓄積されたデータから誤りや重複、表記ゆれを取り除き、分析や業務にそのまま使える品質へ整える作業です。一度実施すれば完了する取り組みではなく、データが増え続ける限り品質を保ち続ける継続的なプロセスといえます。
手作業や単発のツール導入だけで品質を維持するには限界があります。データがどこから集まり、どう変換され、誰がどう使うのかという流れを設計しない限り、せっかく整えたデータもいずれ乱れていく一方です。継続的に品質を担保するには、データ基盤やデータアーキテクチャの整備とセットでクレンジングを設計する必要があります。
サークレイスは、目的設計からデータアセスメント、クレンジング・名寄せ、データ基盤の構築・統合、運用定着、そしてAI活用による業務変革や意思決定の高度化までを、分断させずワンストップで支援します。DatabricksやSalesforce Data Cloudといったツール選定・導入だけで終わりにせず、実務で成果を出し続けるためのパートナーとして伴走します。
データ品質に課題を感じているなら、まずは一度ご相談ください。
\ データ・AI活用を一気通貫でサポート /

